DataFlow
Interfejs, projekty, opis przepływu, katalog, diagramy, uprawnienia i asystent AI.
Znaczenie: wspólne środowisko pracy nad danymi.DataFlow łączy interfejs pracy zespołu, otwartą warstwę wykonawczą i infrastrukturę klienta. Dane pozostają w hurtowni organizacji, logika jest zapisana w SQL i dbt, a każda zmiana przechodzi walidację i kontrolowaną publikację.
DataFlow łączy interfejs pracy zespołu z warstwą wykonawczą i infrastrukturą. Logika przetwarzania jest zapisana w SQL i dbt, a dane pozostają w hurtowni klienta.
Interfejs, projekty, opis przepływu, katalog, diagramy, uprawnienia i asystent AI.
Znaczenie: wspólne środowisko pracy nad danymi.Pobieranie danych, przetwarzanie, testy, harmonogramy, zależności i wykonania.
Znaczenie: uruchamia opublikowaną logikę.Hurtownia, baza aplikacji, magazyn plików, tożsamość, sieć i środowisko kontenerowe.
Znaczenie: pozostaje środowiskiem działania i utrzymania.Airbyte obsługuje konektory i synchronizację, dbt modele SQL, testy oraz dokumentację, a Dagster harmonogramy, zależności i wykonania. Historia definicji jest zapisywana w Git.
Dane są pobierane ze źródeł do hurtowni i przetwarzane na miejscu. Gotowe modele są udostępniane Power BI, Tableau, Excelowi lub innemu narzędziu analitycznemu.
Mniejsze uzależnienie od dostawcy: logika biznesowa jest zapisana w SQL i dbt, konfiguracja ma historię w repozytorium, a wykonanie opiera się na szeroko stosowanych komponentach. Klient zachowuje swoją pracę także po zakończeniu współpracy.
Projekt roboczy oddziela przygotowanie zmiany od opublikowanej konfiguracji. Zespół widzi różnice w plikach, zależności i pełny plan publikacji; platforma wykrywa konflikty i chroni przed częściowym zapisem.
Wynik na rzeczywistych danych można filtrować, sortować, oglądać na poziomie wiersza i eksportować do CSV lub XLSX.
Modele mają opisy, zależności oraz testy kompletności, unikalności, relacji i reguł biznesowych.
Widać zakres zmiany i wynik walidacji. Publikację wykonuje dopiero osoba z przypisanym uprawnieniem.
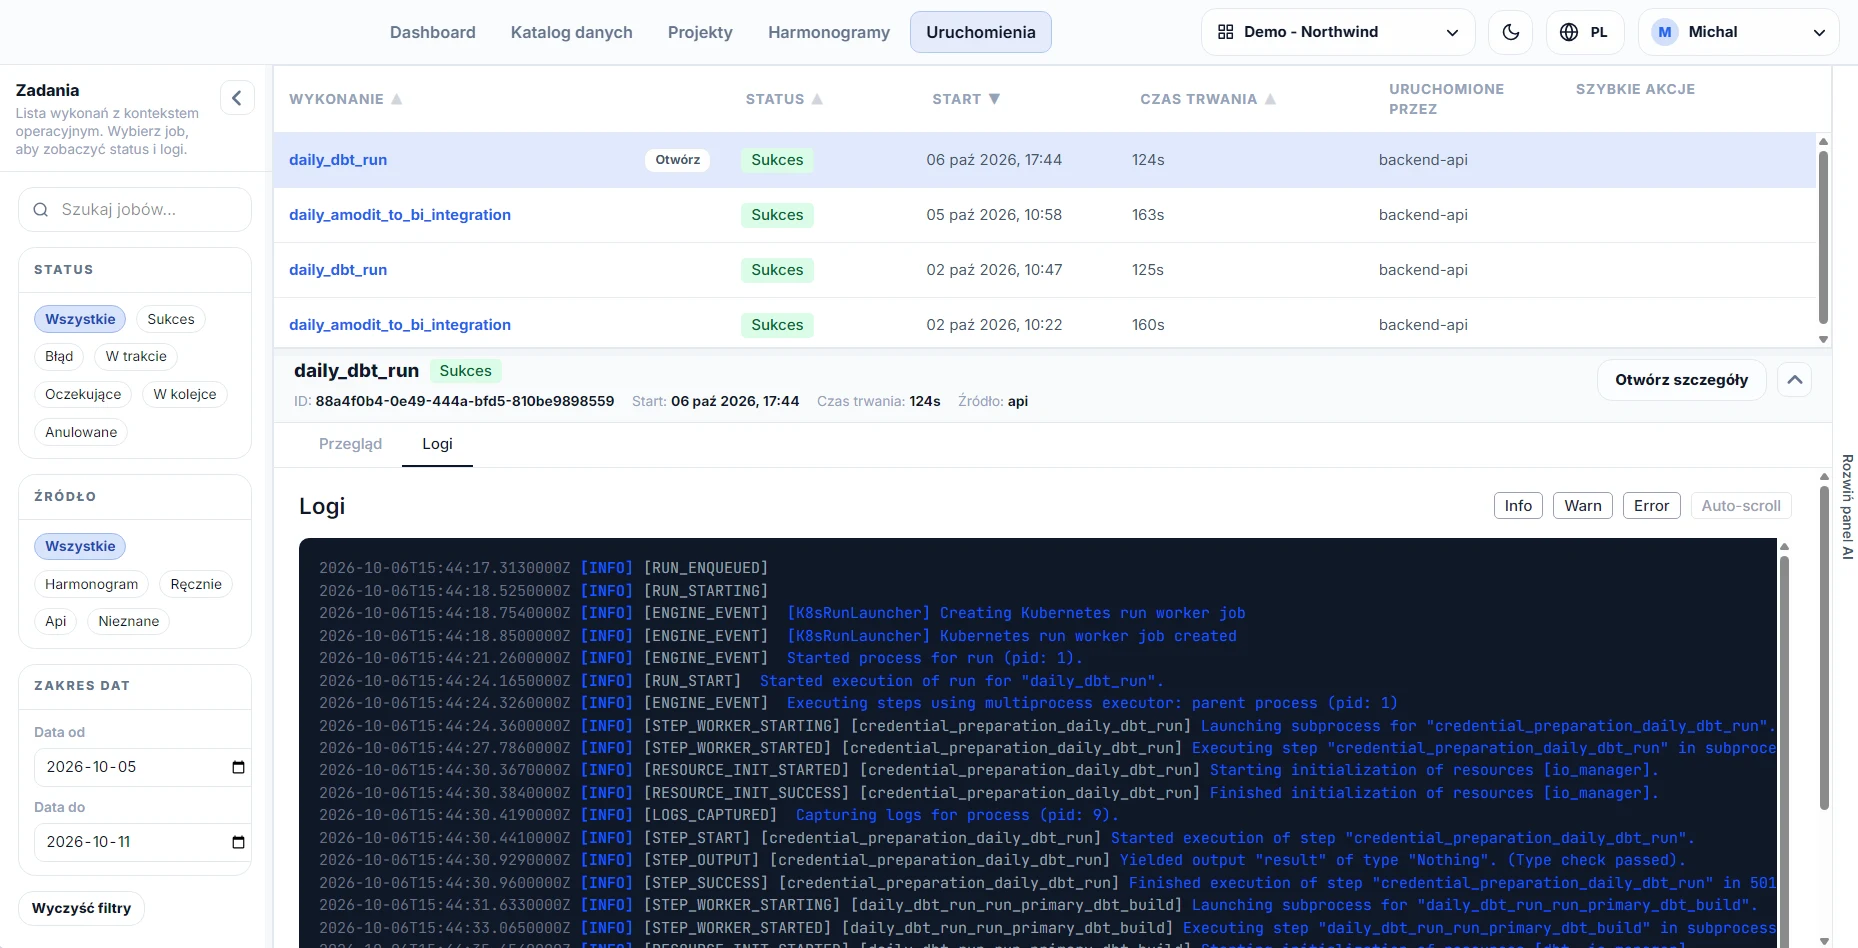
Workbench pokazuje projekty, ich status publikacji, lokalne zmiany i zależności. Asystent AI przygotowuje propozycję w kontekście projektu. Każda propozycja przechodzi walidację i przegląd, a publikacja wymaga uprawnień przypisanych do właściwej roli.
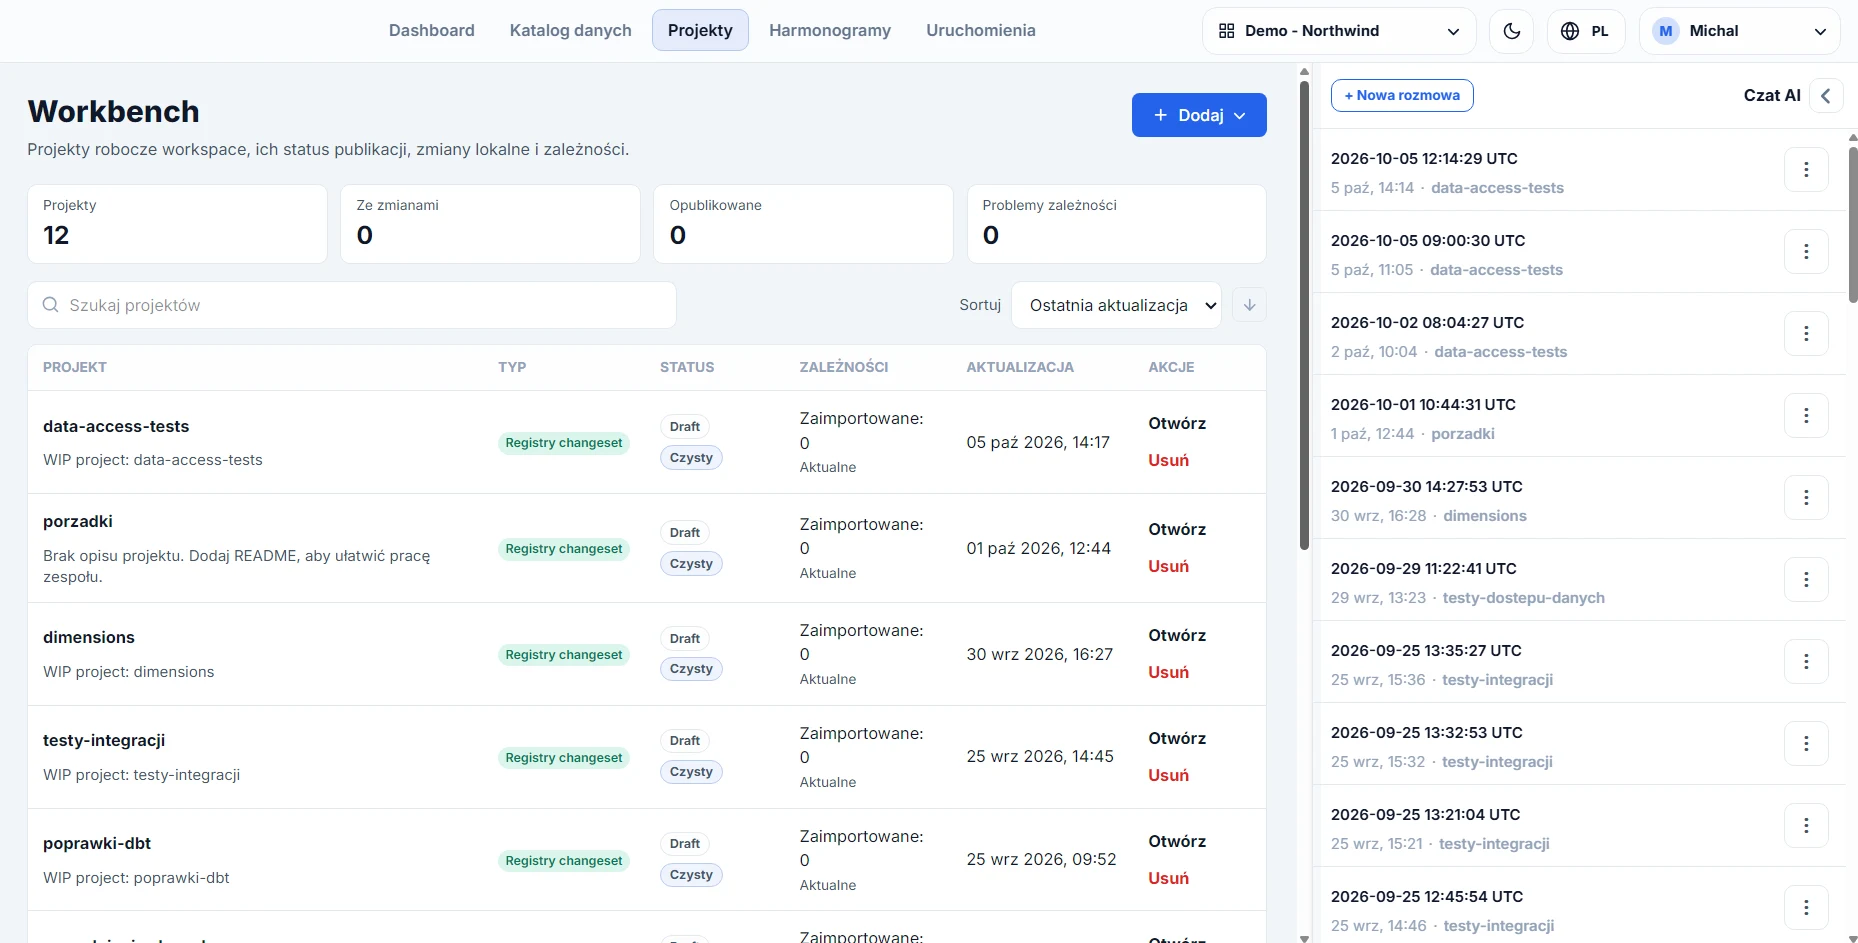
Graf pokazuje źródła, etapy pośrednie i model końcowy. Dla wybranego kroku panel zestawia kolumny wejściowe, rodzaj transformacji, wyrażenie i kolumnę wynikową, a podsumowanie opisuje rolę etapu zwykłym językiem.
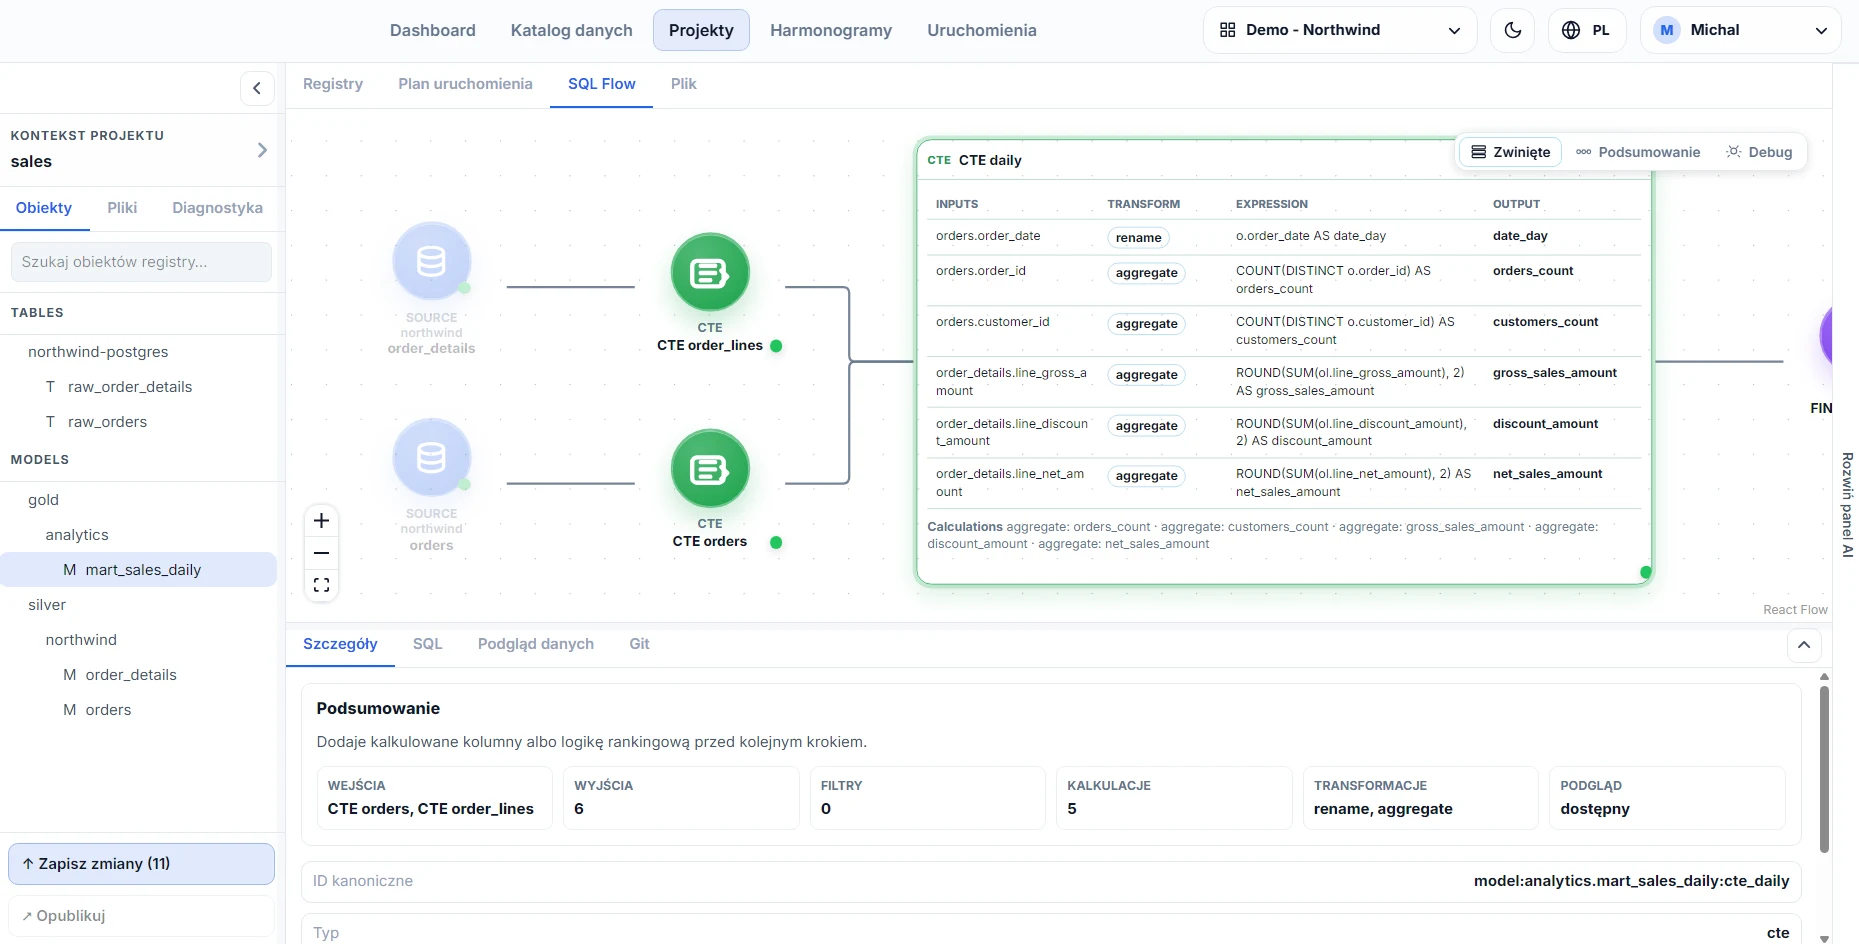
Asystent ma dostęp do struktury danych: katalogu, definicji modeli, zależności, wyników walidacji, diagnostyki i historii uruchomień. Wyjaśnia modele, przygotowuje propozycje zmian i analizuje błędy.
Asystent działa w granicach uprawnień i w projekcie, nie na działającym rozwiązaniu. Widać, co analizuje i co proponuje.
Klient wybiera dostawcę modeli językowych, płaci mu bezpośrednio i decyduje, jakie informacje trafiają do jego usługi.
Dla krótkich, powtarzalnych czynności można ustawić tańszy model, a dla przygotowania zmian mocniejszy. Liczba rund pracy asystenta jest ograniczona ustawieniami.
Każda propozycja przechodzi walidację, przegląd zakresu i publikację przez uprawnioną osobę. Ta sama ścieżka kontroli obowiązuje dla zmian przygotowanych przez AI i człowieka.
Pełny opis pokazuje, gdzie przechowywana jest konfiguracja, jak sprawdzana jest zmiana i jakie informacje pozostają dostępne dla administratora oraz zespołu danych.
Kreator pozwala wyszukać konektor, wprowadzić dostęp, sprawdzić połączenie i wybrać zbiory danych. Można ustawić pełne lub przyrostowe pobieranie, zależnie od źródła.
Korzyść: problemy z dostępem są wykrywane bez budowania każdego połączenia od zera.Raz zapisane poświadczenie obsługuje wiele źródeł. Wartości sekretne nie są ponownie wyświetlane; widać ich wykorzystanie i historię zmian.
Korzyść: dostęp można rotować w jednym miejscu, bez haseł w plikach konfiguracyjnych.Jedna instancja obsługuje wiele przestrzeni z własnymi integracjami, poświadczeniami i rolami. Osobne uprawnienie kontroluje uruchamianie przepływów.
Korzyść: wspólna platforma nie miesza dostępu i odpowiedzialności.Źródła, miejsca docelowe, tabele, modele, zadania i procesy są opisane razem. Graficzny edytor i formularze pokazują całość bez znajomości formatu konfiguracji.
Logika obejmuje czyszczenie, ujednolicanie, łączenie, agregacje i obliczenia. Modele mają opisy, zależności oraz testy kompletności, unikalności, relacji i reguł biznesowych.
Wynik na rzeczywistych danych można filtrować, sortować, oglądać na poziomie wiersza i eksportować do CSV lub XLSX. Regułę biznesową można zweryfikować w tym samym środowisku.
Wyszukiwarka prowadzi do kart zasobów z właścicielem, opisem, schematem, świeżością, kolumnami, wynikami testów i historią zmian.
Graf pokazuje zależności modeli i pochodzenie na poziomie kolumn, a wizualna analiza SQL rozkłada zapytanie na etapy opisane zwykłym językiem.
Widać uruchomienia, kroki, czasy, rekordy i błędy. Zadanie można uruchomić ręcznie, ponowić lub anulować zgodnie z uprawnieniami.
Konfiguracja ma historię, różnice i możliwość równoległej pracy. Zmiany można przeglądać w aplikacji bez znajomości narzędzi programistycznych.
Hurtownia danych należy do klienta niezależnie od miejsca uruchomienia platformy. Przed wdrożeniem definiujemy dostęp, odpowiedzialność i informacje przekazywane do usług zewnętrznych.
Platforma obsługuje logowanie lokalne oraz SSO oparte na OIDC. Połączenie z firmowym systemem tożsamości konfigurujemy we wdrożeniu.
Role w aplikacji określają dostęp do funkcji, a uprawnienia hurtowni — dostęp do danych. Odbiorcom BI można udostępnić tylko warstwę analityczną.
Sekrety można podmienić, ale nie odczytać. Historia pokazuje, kto je zmienił i które źródła z nich korzystają.
Asystent działa w granicach uprawnień. Klient decyduje, do czyjej usługi trafia przekazywany kontekst.
Repozytorium, historia poświadczeń, logi wykonań i statusy operacji pozwalają prześledzić zmiany i uruchomienia.
Uprawnienia są sprawdzane po stronie serwera, a zmiana trafia do użycia dopiero po walidacji i przeglądzie.
Widok Registry łączy źródło, połączenie i tabele docelowe. Asystent AI analizuje kolumny i proponuje konfigurację polityk dostępu. Propozycję sprawdza i zatwierdza człowiek przed publikacją.
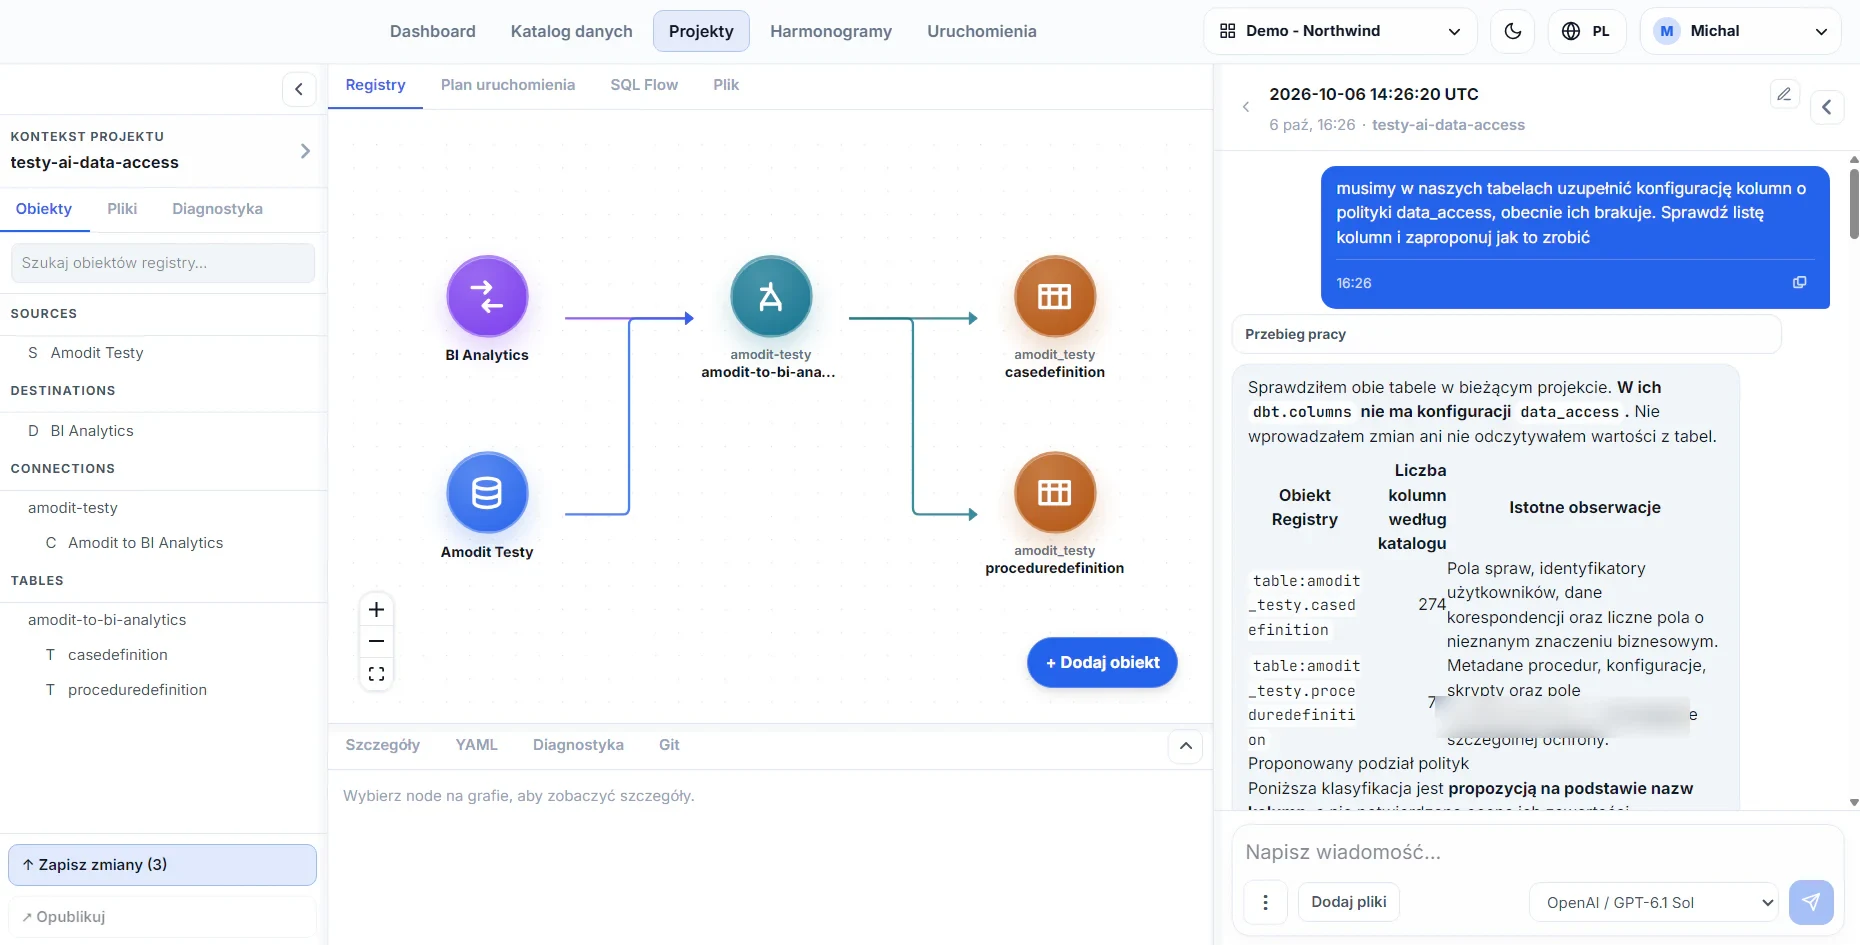
Lista wykonań pokazuje status, moment startu, czas trwania i liczbę rekordów. Po wybraniu zadania można przejść do szczegółów i logów, aby sprawdzić przebieg albo znaleźć przyczynę błędu bez otwierania osobnej konsoli.
DataFlow korzysta z ekosystemu ponad 500 gotowych konektorów. System podłączamy przez API, bazę danych, plik albo konektor przygotowany dla aplikacji wewnętrznej.
| Kategoria | Przykładowe systemy i źródła |
|---|---|
| ERP i księgowość | Comarch ERP XL i Optima, enova365, Symfonia, Subiekt, SAP |
| CRM i sprzedaż | Pipedrive, HubSpot, Salesforce |
| Obsługa klienta i helpdesk | Freshdesk, Zendesk, Intercom |
| Praca i projekty | Jira, Asana, Monday, Paymo, Trello |
| Marketing i reklama | Google Ads, Meta Ads, LinkedIn Ads, Google Analytics, Mailchimp |
| Bazy danych | Microsoft SQL Server, PostgreSQL, MySQL, Oracle, MongoDB |
| Pliki i usługi plikowe | Excel, CSV, Google Sheets, SharePoint, FTP, SFTP i magazyn obiektowy |
| Systemy wewnętrzne | Aplikacje własne przez API, bazę danych lub konektor dedykowany |
| Punkt wyjścia | Jak jest dziś | Co zmienia DataFlow |
|---|---|---|
| Arkusze kalkulacyjne | Dane pobierane ręcznie, logika w formułach, wersje jako pliki z datą. | Automatyczne pobieranie, jawna logika, historia zmian i testy przed publikacją. Excel zostaje narzędziem odbioru. |
| Alteryx lub KNIME na stanowiskach | Workflow jako plik na komputerze, licencja przypisana do osoby, wersje przez nazwy plików. | Centralna platforma, uruchomienia serwerowe, diagram z opisem etapów i przegląd różnic między wersjami. |
| Wersja serwerowa Alteryx lub KNIME | Logika w formacie narzędzia, przetwarzanie w jego silniku, katalog i pochodzenie jako osobne zagadnienie. | Logika w SQL i dbt, przetwarzanie w hurtowni klienta, historia w Git oraz wbudowany katalog i pochodzenie kolumn. |
| Własny zestaw open source | Osobne konsole Airbyte, dbt i Dagster, integracja i utrzymanie własnymi siłami. | Jedna aplikacja: wspólny opis przepływu, katalog, role i uprawnienia oraz zespół wdrażający i utrzymujący rozwiązanie. |
DataFlow potrzebuje połączenia ze źródłami danych i hurtownią. Asystent AI łączy się z usługą wybranego dostawcy modeli. Analiza środowiska przed wdrożeniem wskazuje konkretne kierunki komunikacji i przypisuje odpowiedzialność.
Po aktywacji DataFlow działa bez stałej łączności z serwerem licencyjnym przez okres ważności zainstalowanej licencji. Administrator otrzymuje z wyprzedzeniem informację o zbliżającym się końcu ważności.
Dla instalacji bez dostępu do internetu dostępny jest tryb aktywacji offline.
Rozwój DataFlow obejmuje obsługę znanych podatności i aktualizacji bezpieczeństwa. Zobacz, jak odnosimy produkt do wymagań CRA.
Każdy komponent ma własny zestaw testów automatycznych. Wydanie powstaje dopiero po ich przejściu.
Każde wydanie przechodzi kontrolę znanych podatności oraz bramkę bezpieczeństwa z ustaloną obsługą wyjątków.
Testy obejmują administrację, integracje, poświadczenia, katalog, pochodzenie, zmianę, przepływy, harmonogramy i uruchomienia.
Logika jest w SQL, konfiguracja ma historię w repozytorium klienta, a warstwa wykonawcza korzysta z otwartych komponentów.
Klient wybiera dostawcę modeli i decyduje, do czyjej usługi trafia przekazywany kontekst. Zakres informacji przekazywanych do modelu ustalamy podczas wdrożenia.
W infrastrukturze klienta albo w hostingu po stronie Astrafox. W obu wariantach hurtownia danych pozostaje po stronie klienta.
Sama licencja nie wymaga stałej łączności: po aktywacji platforma działa bez połączenia z serwerem licencyjnym przez okres ważności licencji, a dla instalacji odciętych od internetu dostępna jest aktywacja offline. Pozostałe połączenia zależą od źródeł, hurtowni i wybranej usługi AI.
Zmiana powstaje w projekcie roboczym. Zespół przegląda różnice, zależności, wyniki walidacji i podgląd danych, a publikację wykonuje osoba z odpowiednim uprawnieniem.
Zmapujemy źródła, hurtownię, tożsamość, połączenia sieciowe i odpowiedzialność za utrzymanie.
Opisz środowisko danych